
BLOG
Il contesto cambia tutto: cosa ci ha insegnato la settimana più importante del Legal Tech sul prossimo capitolo dell’IA
Rebecca Sattin
Direttore senior del reparto Partner Success
Ogni estate, migliaia di persone che sviluppano, acquistano e gestiscono le tecnologie alla base dell’attività legale trascorrono una settimana a scambiarsi opinioni all’ILTACON, la conferenza annuale organizzata dall’International Legal Technology Association (ILTA). Se non ci siete mai stati, ecco una breve sintesi: non si tratta di una fiera incentrata sulla roadmap di un singolo fornitore. È un evento organizzato da professionisti del settore, con oltre 80 sessioni formative quest’anno selezionate tra più di 400 proposte presentate dalla stessa comunità ILTA.
Ho avuto il privilegio di collaborare come volontario con l’ILTA per aiutare a coordinare diverse di quelle sessioni, occupandomi sia di intervistare i relatori sia di guidarli nella stesura degli appunti per i loro interventi.
Il filo conduttore che ha accomunato tutte le sessioni di quest’anno è stato il seguente: il settore legale ha smesso di discutere se utilizzare o meno l’intelligenza artificiale e ha iniziato a confrontarsi con la questione di come assumersene la responsabilità – per quanto riguarda i costi, la governance e le persone che devono effettivamente utilizzarla.
Ecco ciò che mi è rimasto più impresso.
Il contesto è la risorsa che genera rendimenti composti
Il modello mentale più utile che ho sentito in tutta la settimana è stato anche il più semplice, e NetDocuments lo ha utilizzato per introdurre il nostro “Company Update”: sono tre gli elementi che determinano se un agente di intelligenza artificiale sia effettivamente bravo nel proprio lavoro:
- Il modello sottostante,
- L'infrastruttura (l'applicazione o l'assistente) sviluppata attorno ad esso, e
- Il contesto a cui può attingere mentre opera.
I modelli vengono noleggiati; vengono aggiornati e sostituiti secondo il programma del laboratorio, non secondo il tuo.
Le piattaforme vengono sostituite continuamente e la maggior parte delle organizzazioni ne utilizza già più di una.
Il contesto – ovvero l’insieme organizzato e gestito dei documenti, dei precedenti e delle conoscenze istituzionali di un’organizzazione – è l’unico livello di cui un’organizzazione è effettivamente proprietaria, nonché l’unico dei tre che si arricchisce anziché azzerarsi ogni volta che si cambia strumento.
Questa distinzione è verificabile, non è solo uno slogan. NetDocuments ha pubblicato il “Legal Context Engineering Benchmark” per misurare il valore di un contesto migliore – sia in termini di qualità delle risposte che in termini economici – ponendo le stesse 300 domande a un modello di IA e a un’applicazione fissi, modificando solo il contesto a cui l’agente poteva accedere. In un caso di test basato su una fusione reale, con un contesto scarso, la risposta ha ottenuto un punteggio di 0,10/1,0; con un contesto più ricco, 0,67 — quasi 7 volte migliore.
Su un totale di 300 domande di test relative a 10 casi giuridici reali, il modello si è confermato: un contesto più articolato ha reso le risposte corrette circa il 48% più economiche da elaborare, senza compromettere l’accuratezza, e il vantaggio si è rivelato più marcato nei modelli più potenti rispetto a quelli meno potenti – il che costituisce la base per un risparmio annuo stimato di 942.000 dollari per uno studio legale con 2.000 utenti.
NetDocuments ha pubblicato la propria metodologia completa proprio per consentire a qualsiasi organizzazione di eseguire lo stesso test sui propri documenti, anziché limitarsi ad accettare i risultati per buoni. In sintesi: il contesto riduce drasticamente l'uso dei token e i costi dell'IA.
Questa settimana è stato inoltre presentato uno strumento davvero utile e indipendente dai fornitori, pensato per fare chiarezza: cinque domande da porre la prossima volta che qualcuno – compreso un fornitore con cui già collabori – sostiene che il proprio prodotto abbia un “contesto”.
- Cosa comprende o ricava effettivamente il sistema dai tuoi documenti?
- In che modo individua le informazioni rilevanti di cui ha bisogno?
- Quali autorizzazioni determinano ciò che l'IA può recuperare?
- Quel contesto regolamentato può estendersi agli strumenti di IA che la vostra organizzazione sceglie effettivamente di adottare?
- E quali dati dimostrano l'impatto sulla qualità delle risposte e sui costi?
L'architettura è importante, ma lo sono anche i dati concreti.
Vale la pena chiarire con precisione cosa comprenda il termine “contesto”, poiché la maggior parte dei fornitori, NetDocuments compreso, descrivono diversi livelli tecnici distinti con un unico termine: la classificazione automatica e l’estrazione dei metadati che non richiedono alcuna configurazione, la profilazione personalizzata che un’organizzazione configura per la propria tassonomia, la ricerca semantica che individua il significato anziché limitarsi alle parole chiave, e un grafico connettivo che collega documenti, persone e argomenti – ancora in anteprima privata alla conferenza di quest’anno, non una funzionalità già disponibile per tutti i clienti. Considerare questi elementi come un’unica cosa anziché come quattro è esattamente ciò che porta a un’esagerazione delle affermazioni sul “contesto”.
Un altro tema chiave del dibattito sul contesto era la possibilità di collegarsi agli strumenti di IA scelti da un’organizzazione tramite il Model Context Protocol (MCP), anziché dover trasferire i file al di fuori del sistema di riferimento, solitamente il sistema di gestione documentale dell’azienda. Le prove, per quel che valgono, stanno iniziando a provenire dai clienti piuttosto che dai fornitori.
Thomas Kline, direttore dell’Information Technology presso Stark & Stark, ha descritto come il motore di ricerca e risposta basato sull’intelligenza artificiale Perplexity sia stato collegato all’archivio documentale del suo studio tramite MCP (ne parleremo più avanti): “Nessun caricamento di documenti. Nessuna selezione di file. I nostri avvocati devono semplicemente indirizzare l’IA verso un caso, e questa opera attingendo a tutto ciò a cui hanno già autorizzazione di accesso”. E Jeff Westcott di Akin, durante una tavola rotonda con i clienti, ha offerto il consiglio più chiaro della settimana a chiunque si senta sommerso da soluzioni puntuali: «più si riesce a fare all’interno della piattaforma, meglio è».
La resa dei conti: dalla sperimentazione alla responsabilità
Negli ultimi anni, la strategia in materia di IA della maggior parte delle organizzazioni si è ridotta a entusiasmo e carta di credito: sperimentare tutto, preoccuparsi del conto in un secondo momento. Josh Baxter, CEO di NetDocuments, ha definito questa fase con un termine ormai comune: “tokenmaxxing”, ovvero spingere le persone a utilizzare l’IA, a usarla sempre di più, a sperimentare di tutto, senza limiti. Con l’avvento di un modello di tariffazione basato sul consumo, in sostituzione del buffet illimitato di token, quella fase sta volgendo al termine. Ora, molte organizzazioni stanno invece adottando misure di razionamento: limiti di utilizzo, budget e decisioni su chi ha accesso a quali strumenti.
I numeri spiegano il perché. Il fatturato dei grandi studi legali è aumentato di oltre il 12% nei primi sei mesi dell’anno, con una crescita della domanda di servizi legali (misurata in ore lavorate) del 4,8%. Tuttavia, i clienti stanno contemporaneamente esercitando forti pressioni affinché l’intelligenza artificiale riduca i costi a loro carico. Il discorso di chiusura di giovedì, una sintesi delle discussioni tenutesi durante gli incontri dei vertici G100 e G200 dell’ILTA, moderato da Dan Hauck, Chief Product Officer di NetDocuments, ha fornito dati concreti a sostegno di tale preoccupazione.
La spesa per l’IA dichiarata dalle aziende copre un intervallo enorme, che va da circa 100.000 dollari fino a ben 35 milioni di dollari, e sta emergendo una regola empirica di settore secondo cui la spesa totale per l’IA dovrebbe attestarsi intorno all’1% del fatturato. Se a ciò si aggiunge il modello di tariffazione basato sul consumo – in cui il costo dipende dall’intensità di utilizzo di uno strumento – molti responsabili finanziari e dell’innovazione nutrono una certa apprensione per i costi difficili da prevedere in anticipo.
Un recente sondaggio di Gartner condotto su oltre 780 responsabili IT ha rilevato che solo il 28% dei casi d’uso dell’IA ha pieno successo e soddisfa le aspettative di ROI. Un CIO presente al panel ha offerto la visione più onesta della settimana riguardo alla misurazione del ritorno in un mercato in rapida evoluzione: «Gli strumenti che abbiamo oggi non saranno quelli che avremo domani… quindi, voglio davvero dedicare 500 ore a calcolare il ROI oggi? È un concetto privo di senso. Finché è positivo, si va avanti». Un altro partecipante al panel ha riformulato l’intero approccio in termini di «fallire in fretta, ritorno sull’impegno» piuttosto che ritorno sull’investimento – una distinzione che conta quando gli strumenti stessi hanno una durata di vita misurabile in mesi.
Quella stessa tavola rotonda ha messo in luce un aspetto su cui vale la pena riflettere, indipendentemente dal settore in cui si opera. James McKenna, CIO di Foley & Lardner, ha descritto come ha visto i clienti evolversi, secondo le sue parole, da “non si può usare l’IA” a “quale IA state usando”, fino ad arrivare oggi, semplicemente, a “diteci come state usando l’IA”. La richiesta di IA si è silenziosamente trasformata in una richiesta di trasparenza e semplicità nei prezzi. «Bisogna capire quanto costa ottenere una risposta», ha affermato. «Non complicate troppo la fatturazione. Mantenetela semplice».
Questo si riflette anche nel modo in cui le aziende concepiscono il proprio modello di business. Una sessione intitolata “Il paradosso dell’ora fatturabile: rendere visibile (e prezioso) il lavoro non fatturabile” ha affrontato la stessa tensione da una prospettiva diversa, e il panel di giovedì ha dedicato molto tempo a ciò che un relatore ha definito “l’ascesa dell’ingegnere legale” – nuovi ruoli a metà strada tra avvocato, tecnologo e knowledge manager, perché fornire servizi legali in modo redditizio in un mondo basato sui prezzi al consumo richiede una composizione del team diversa rispetto a quella necessaria per fornire tali servizi sulla base dell’ora fatturabile.
Gartner ha iniziato a definire chiaramente questo cambiamento, descrivendo la disciplina di cui le organizzazioni hanno ora bisogno come“ingegneria del contesto”– utilizzandola per migliorare l’accuratezza dei risultati dei modelli di IA, aumentarne la pertinenza e ridurre l’utilizzo di token, abbassando così i costi operativi. Qualunque sia il nome che gli si attribuisca, il messaggio è lo stesso: il dibattito si è spostato dal “stiamo utilizzando l’IA” al “possiamo dimostrare il suo valore?”.
L'autonomia senza governance non è progresso
Man mano che gli strumenti di intelligenza artificiale passano dal rispondere alle domande all’intraprendere azioni concrete – redazione, archiviazione, riferimenti incrociati, segnalazione – questa settimana è emersa ripetutamente la frase “gli agenti sono utenti”. John Motz, Chief Technology Officer di NetDocuments, ha osservato durante la sessione “Company Update”: “Le persone stanno iniziando a rendersi conto che gli agenti sono utenti, e sono utenti davvero intelligenti, quindi dobbiamo pensare al loro accesso e ai controlli proprio come per un utente normale, se non in modo ancora più attento”.
Pallavi Nargund di Amazon Web Services ha poi illustrato il caso d’uso relativo alla sicurezza in termini più concreti: i clienti hanno accesso a un modello a più livelli basato sull’isolamento, con crittografia resistente alla crittografia quantistica già applicata ai documenti archiviati, in modo che, anche in caso di violazione di un livello di sicurezza, i dati, la memoria e l’hardware sottostante rimangano isolati in modo indipendente, salvaguardando la riservatezza dei clienti, la privacy dei dati e la proprietà intellettuale dell’organizzazione.
Quella stessa tensione – una maggiore autonomia che richiede una maggiore governance – è emersa come tema portante in sessioni tra loro non collegate: “Oltre la Carta: quadri di governance dell’IA che funzionano davvero”, “L’uomo agente segreto: quando l’IA inizia ad agire di propria iniziativa” e “Mobilità della materia: gestione del rischio, dell’accesso e della responsabilità” hanno tutte affrontato una versione della stessa questione. Una sessione di domande e risposte durante il panel dedicato agli aggiornamenti aziendali ha insistito proprio su questo punto: è possibile ricostruire ciò che un agente ha effettivamente fatto, passo dopo passo, e si possono revocare o annullare le sue azioni se qualcosa va storto?
Queste non sono domande ipotetiche quando uno strumento di intelligenza artificiale ha accesso permanente ai fascicoli di un cliente, anziché limitarsi a esaminare i risultati che un avvocato approva a posteriori. Il collegamento in sé non è la parte difficile. Lo sono invece gli elementi che devono accompagnarlo: autorizzazioni, barriere etiche, tracciati di controllo.
Questo si sta già vedendo nel modo in cui i fornitori di IA integrano i propri prodotti. Nel corso della settimana, Google e NetDocuments hanno annunciato una nuova integrazione tra Gemini Enterprise for Legal e NetDocuments tramite il Model Context Protocol (MCP), che va ad aggiungersi alle integrazioni già esistenti con Claude, Microsoft Copilot e Perplexity, oltre che con altri strumenti legali come Harvey e Legora.
Il principio di progettazione alla base di questa soluzione è quello che vale la pena adottare indipendentemente dai fornitori utilizzati: la governance deve accompagnare automaticamente la connessione, non essere un’impostazione che qualcuno deve ricordarsi di attivare.
L'adozione è una questione che riguarda le persone, non un problema di software
Alcune delle discussioni più concrete della settimana non hanno riguardato affatto i modelli all’avanguardia, ma le persone. La masterclass di NetDocuments, intitolata “Adapt, Adopt, Transform” (Adattarsi, Adottare, Trasformarsi), si è aperta con una citazione del futurista Alvin Toffler, scritta più di 50 anni fa ma oggi più che mai attuale: “Gli analfabeti del XXI secolo non saranno coloro che non sanno leggere e scrivere, ma coloro che non sanno imparare, disimparare e reimparare”.
Kathleen Hogan, partner specializzata in innovazione legale, ha approfondito questo concetto sulla base della ricerca del dottor Larry Richards sul“cervello dell’avvocato”: gli avvocati sono addestrati a essere scettici (individuare ciò che potrebbe andare storto è il loro lavoro), a privilegiare i precedenti rispetto alla novità, a preferire l’autonomia piuttosto che ricevere istruzioni su cosa fare e a scartare del tutto uno strumento imperfetto piuttosto che correggerne i difetti. Questi punti di forza professionali, ha tenuto a precisare, non sono difetti caratteriali, ma caratteristiche che fanno sì che la gestione standard del cambiamento si ritorca contro uno studio legale.
Hogan ha inoltre citato il concetto di “Trust Gap” (divario di fiducia) del consulente di leadership aziendale Andy Stanley: la distanza tra ciò che le persone si aspettano dalla leadership e ciò che effettivamente sperimentano. La sessione ha collegato il Trust Gap anche all’uso degli strumenti di IA, sottolineando che tale divario si manifesta in modo asimmetrico: una sola esperienza negativa con l’IA supera di peso dieci esperienze positive, perché “quella volta non ha funzionato” diventa l’unica storia che le persone raccontano.
Lo ha illustrato con un esempio concreto: uno dei primi progetti pilota di IA in un’azienda ha inavvertitamente invertito una singola cifra nel numero di telefono di un cliente, un errore che nessuno ha notato per molto tempo, proprio perché nessuno lo stava controllando. La lezione non era “non usate l’IA”, ma che la verifica deve essere integrata in modo deliberato nel flusso di lavoro, perché la revisione dei risultati dell’IA è di per sé un compito impegnativo che viene trascurato proprio quando le persone sono più indaffarate.
Kyle Kissell, direttore del team Legal Innovation Partner di NetDocuments, ha sottolineato che il divario tra la comprensione di uno strumento e il semplice fatto di utilizzarlo per risolvere un problema è proprio la fonte principale di delusione. Ha portato l’esempio di quando ha chiesto a suo figlio di falciare il prato e ha ottenuto esattamente questo, ma senza che il ragazzo svuotasse il cesto di raccolta e mettesse l’erba tagliata nei sacchi, poiché non gli aveva fornito quelle istruzioni specifiche. Istruzioni vaghe portano a risultati letterali, tecnicamente corretti, ma a volte inutili – sia da parte di una persona che di un agente di intelligenza artificiale.
Questo sentimento è stato rispecchiato in una delle mie sessioni intitolata “Adozione dell’IA incentrata sull’uomo: un manuale pratico di formazione per organizzazioni legali e uffici legali aziendali”. Tra i relatori figuravano un formatore tecnologico, un direttore della gestione della conoscenza, un avvocato del team di innovazione del proprio studio legale e il cofondatore di Hotshot, un’azienda specializzata nell’adozione dell’IA. L’opinione comune era che nulla possa sostituire il lavoro pratico e concreto all’interno di una piattaforma per favorire l’adozione: un apprendimento breve, guidato ed esperienziale, basato sui profili degli utenti e specifico per la pratica professionale.
Questo non vale solo per gli studi legali. È un promemoria del fatto che, in qualsiasi settore, il collo di bottiglia nell’adozione dell’intelligenza artificiale raramente è la tecnologia. Il punto è se le persone che la utilizzano comprendono effettivamente come impiegarla in modo efficace nelle loro specifiche mansioni lavorative e se hanno fiducia in ciò che fa.
Informati su ciò che possiedi già prima di acquistare le novità
Il consiglio più concreto della settimana è stato anche il meno appariscente: prima di acquistare qualsiasi cosa di nuovo, chiediti quale sia il tuo obiettivo reale e lascia che sia quel flusso di lavoro – e non la roadmap di un fornitore – a guidare l’investimento.
Con quasi 1.200 strumenti di intelligenza artificiale che oggi si contendono l’attenzione di un acquirente del settore legale, più di una volta è emersa una domanda diagnostica davvero utile: la vostra attuale infrastruttura tecnologica è già in grado di coprire l’80% del flusso di lavoro in questione?
E invece di cercare di indovinare dove siano le lacune, dai un’occhiata ai log delle tue richieste per capire cosa chiedono effettivamente gli utenti. I dati reali sull’utilizzo hanno sempre la meglio sull’intuizione.
Quella stessa disciplina si applica a un livello inferiore, ai dati alla base di qualsiasi iniziativa di intelligenza artificiale.
Durante una sessione dedicata alla creazione di quello che NetDocuments definisce un “data estate” abilitato per l’MCP, Nate Ruiz di NetDocuments ha esordito con una semplice argomentazione, ripresa anche dagli altri relatori: se non si sa quali dati si possiedono, non si sa cosa se ne possa fare – e non si saprà nemmeno quali dati vengono esposti a uno strumento di IA generativa.
Le aziende stanno integrando sempre più spesso i dati strutturati (quelli che risiedono in un database con metadati e una tassonomia che ne definisce il contesto) con i dati non strutturati (quelli i cui dettagli sono nascosti nei documenti e nelle e-mail), e il consiglio condiviso non verteva tanto sulla scelta di un’unica architettura “giusta”, quanto piuttosto sulla creazione di una base di dati pulita e ben comprensibile prima di aggiungervi ulteriori livelli di intelligenza artificiale.
Qualunque cosa riservi il futuro in questo settore – e ogni settimana arriva qualcosa di nuovo – un’azienda che conosce già i propri dati è in una posizione migliore per sfruttarli.
Come si presentava la situazione sul campo
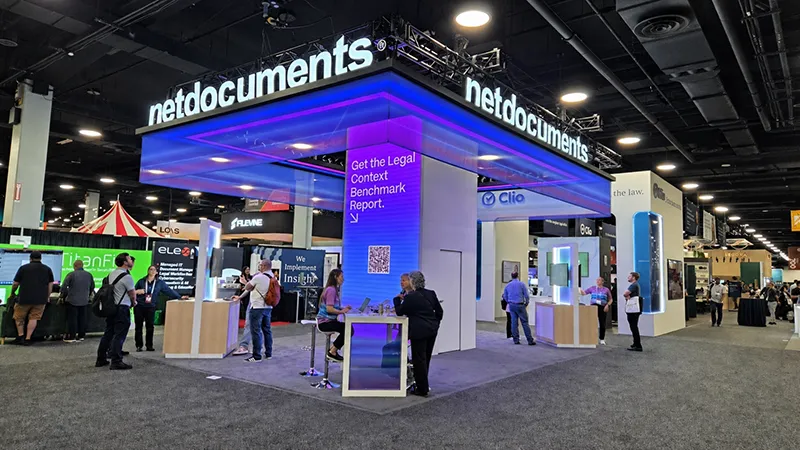
Per chi fosse curioso di conoscere i dettagli: NetDocuments ha approfittato di questa settimana per condividere una serie di aggiornamenti che si inseriscono perfettamente in questi temi. Oltre al rapporto di benchmark citato in precedenza, l’azienda ha lanciato nuove funzionalità basate sull’intelligenza artificiale per la revisione di tabelle e l’individuazione di riferimenti giuridici all’interno dei documenti, ha annunciato l’integrazione con Gemini Enterprise ed è stata inserita per il quinto anno consecutivo nella classifica Inc. 5000 del 2026.
La nostra esperienza utente ripensata e il Legal Context Graph, presentati per la prima volta a maggio, vengono implementati in modo graduale anziché tutto in una volta: un’esperienza di base riprogettata è ora disponibile per tutti i clienti, mentre il Legal Context Graph basato sull’intelligenza artificiale seguirà in anteprima privata senza scadenze obbligatorie per la migrazione – un ritmo che un relatore ha sintetizzato come “non un unico grande lancio, ma una serie di cambiamenti a cascata”.
L’esperienza di fare il volontario a ILTACON è unica. Avere l’opportunità di collaborare con altri partner commerciali e membri dell’ILTA all’organizzazione di questa conferenza è davvero gratificante, dalle conversazioni con il mio team alla collaborazione con i relatori. Sono le persone a rendere speciale l’ILTA, e la conferenza di quest’anno potrebbe essere stata la migliore di sempre. Grazie a tutti coloro che hanno proposto un’idea per una sessione, sono intervenuti in una tavola rotonda o si sono semplicemente presentati pronti a scambiarsi opinioni. Conferenze come questa funzionano solo perché i professionisti del settore sono disposti a condividere con generosità ciò che hanno imparato. Se le conversazioni di quest’anno sono indicative, il prossimo capitolo dell’IA nel settore legale non sarà vinto da chi si muove più velocemente, ma da chi costruirà le basi più affidabili.
Continua la conversazione
Se questo articolo vi ha fatto riflettere su come si presenta effettivamente il contesto della vostra organizzazione in questo momento – e se reggerebbe una prova come quella descritta sopra – NetDocuments terrà un webinar il 17 settembre: “Legal Context Lives Here: Turning Trusted Content into Better AI”. Si tratta di un passo concreto da compiere, non di una presentazione commerciale: un’occasione per interagire con gli ideatori di questo benchmark, approfondire la metodologia e capire cosa serve per applicare lo stesso approccio ai vostri documenti. Registratevi qui per assicurarvi un posto.
NetDocuments presenta
Inspire 2026
Vi invitiamo a partecipare a Inspire 2026, dove una comunità eterogenea composta da leader del settore, esperti, influencer e colleghi condividerà conoscenze e discuterà delle prossime tendenze nel campo della tecnologia legale.
Condividi
Migliora le tue competenzecon questiblog
-
- Blog
Riepilogo di Inspire 2026: se si parte dal contesto giusto, il resto diventa più facile
All’evento Inspire 2026 di Orlando, in Florida, clienti, partner e rappresentanti del settore legale…
-
- Blog
Oltre l'elenco dei casi d'uso dell'IA: partire dal problema
Tutto ciò che ti serve per lavorare su un caso, proprio a portata di…
-
- Blog
Basta confrontare i documenti legali manualmente: sei nuove app di ndMAX Studio
Tutto ciò che ti serve per lavorare su un caso, proprio a portata di…
-
- Blog
NetDocuments collega le conoscenze giuridiche dell'organizzazione a Microsoft Copilot tramite MCP
Tutto ciò che ti serve per lavorare su un caso, proprio a portata di…